「AIの文章って、こんなに自然なのに間違うの?」
読みやすい文章と、事実に合った文章は同じではありません。
生成AIは文章などを作れますが、その内容が正しいとは限りません。
先に結論:学び方・出力・確かめ方を分けよう
- 学び方を見る:機械学習は、データや報酬などを手掛かりに、予測や行動に役立つパターンを学びます。
- 何を出すかを見る:カテゴリを答える分類、数量を予測する回帰、文章や画像を作る生成などがあります。
- 使う前に確かめる:自然な文章でも、事実の誤りや偏りがあり得ます。出典が付いていても原文を確認しましょう。
AIは、認識・判断・生成などに関わる技術の広い呼び方です。その一分野が機械学習で、ディープラーニングは機械学習の一手法。この記事では、感想文に架空の章が登場した事件から、これらの関係とAIの確かめ方を学びます。
動画で学ぶ人は、情報Ⅰサバイバルの再生リストも活用してください。
AIの感想文に、存在しない「第4章」があった
日曜の夜、感想文の締切は明日。ユウキは対話AI「トーカ」に、本の題名だけを入力しました。すると、原稿用紙4枚ほどの文章が返ってきます。
ユウキ「……天才じゃん。」
翌日、先生は2か所を指さしました。
先生「この本に第4章はないよ。それに、この作家さんはこの賞を受賞していない。」
トーカは架空のサービス名で、事件も動画内の物語です。
ユウキ「AIが間違えたんだよ!」
Sandy「ちょお待ちぃ! 文章が自然なんと、内容が正しいんは別やで。」
なぜ起こるのかを考えるため、まずAIの用語の関係から見ていきましょう。
AI・機械学習・ディープラーニングの関係
AIの中に機械学習があり、その中にディープラーニングがあります。3つは同じ大きさの別物ではありません。
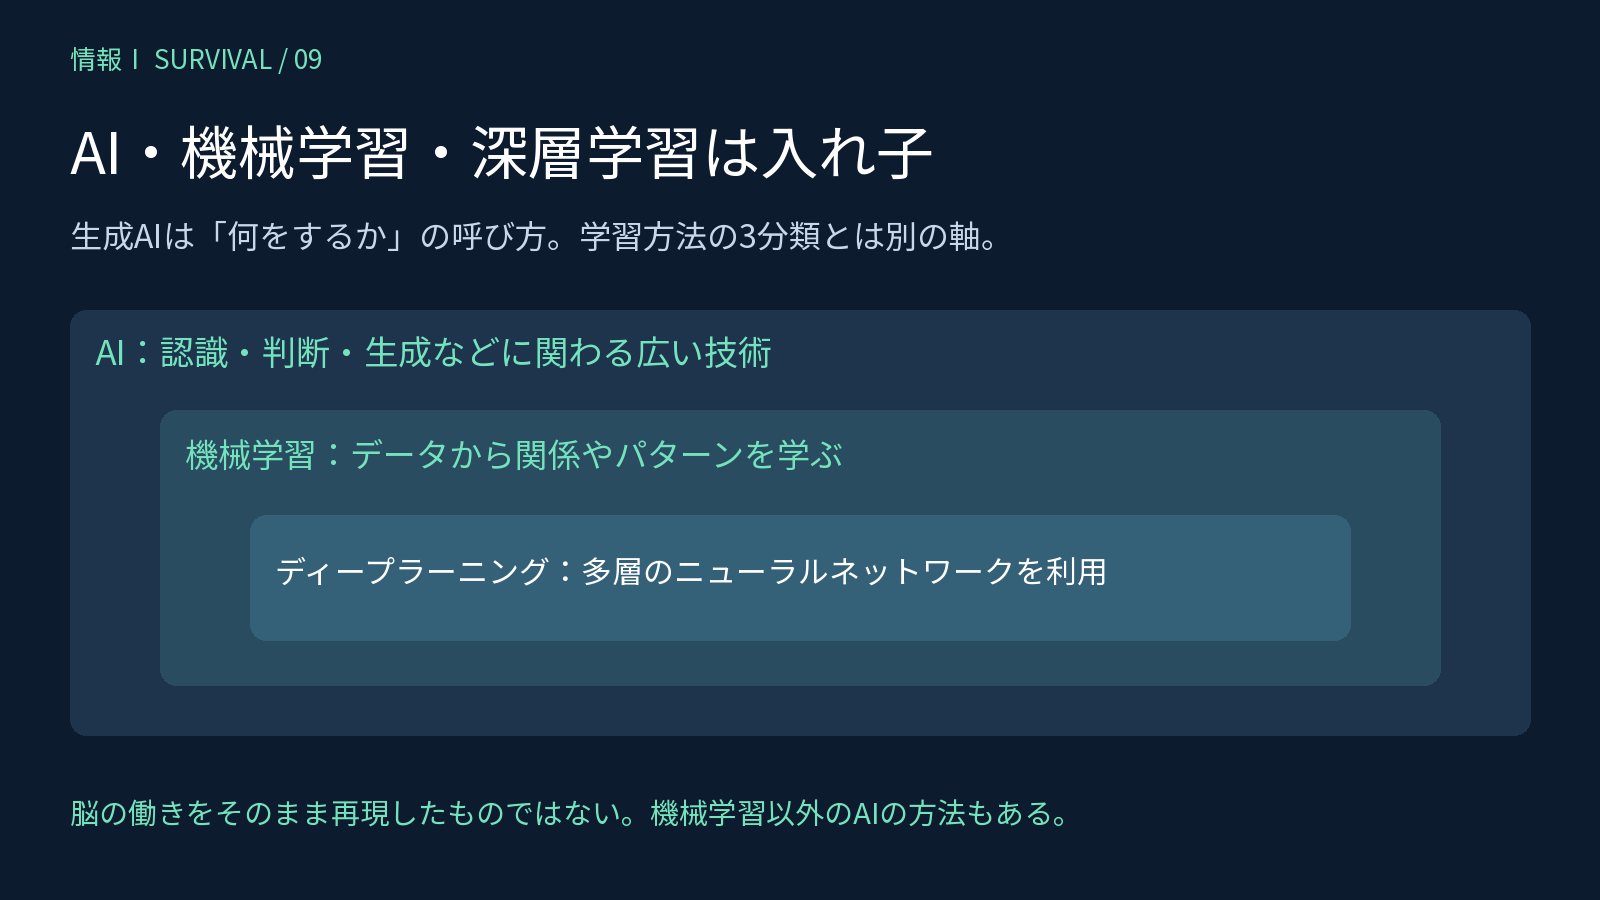
AI・機械学習・ディープラーニングは包含関係で整理する。
機械学習では、データから関係やパターンを学んだ「モデル」を使い、予測や分類などを行います。人がすべての判断ルールを一つずつ書く方法とは異なりますが、人が目的、データ、評価方法などを考えなくてよいわけではありません。
ここで、**学習と、学習したモデルを使うこと(推論)**を分けて考えましょう。
段階 | 迷惑メール判定の例 |
|---|---|
学習 | メールと「迷惑/通常」のラベルを使って、判断に役立つパターンを学ぶ |
推論 | 学習済みのモデルに新しいメールを入れ、「迷惑/通常」を予測する |
学習用のデータだけで良い結果が出ても十分ではありません。学習に使っていないデータでも役立つかを確かめます。
ディープラーニングは、多層のニューラルネットワークを使う方法です。神経回路から着想を得た仕組みですが、人の脳をそのまま再現したものではありません。
生成AIは「新しい内容を作る」という働きに注目した呼び方です。「教師あり学習」「教師なし学習」などと、同じ一列に並ぶ排他的な分類ではありません。
教師あり・教師なし・強化学習は、学ぶ手掛かりが違う
正解付きの例を使うか、ラベルのないデータを使うか、行動への報酬を使うかに注目すると区別しやすくなります。
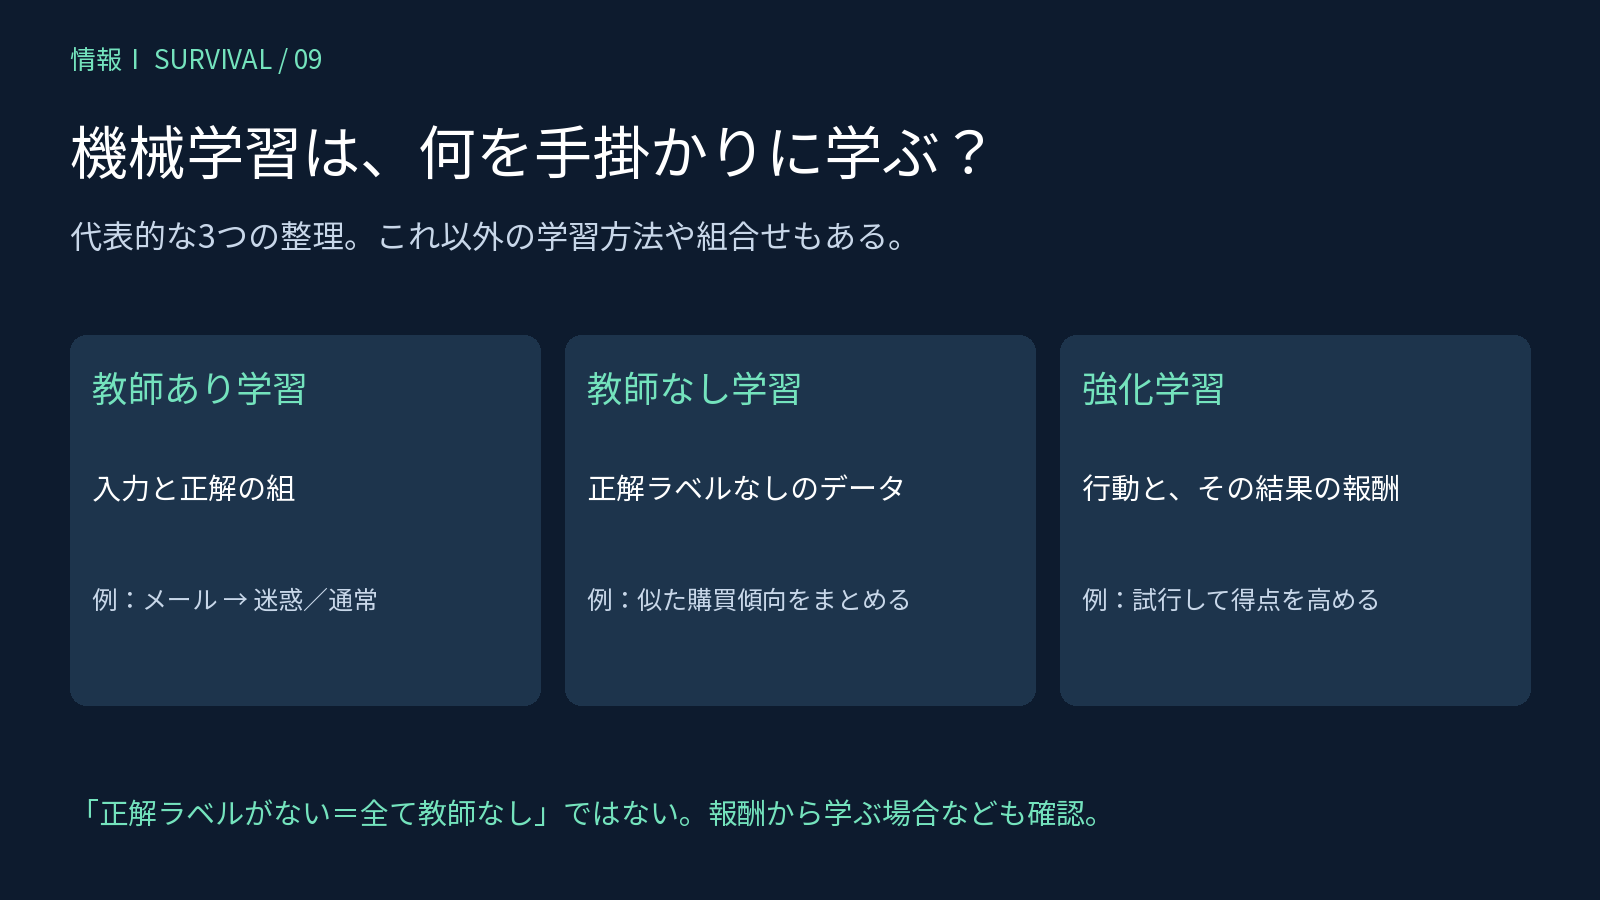
代表的な3つの学習方法は、学ぶ手掛かりが異なる。
代表的な学び方 | 主な手掛かり | 例 |
|---|---|---|
教師あり学習 | 入力と、予測したい答えの組 | メールと「迷惑/通常」のラベル |
教師なし学習 | 正解ラベルを付けないデータの構造 | 購買傾向の似た顧客をグループにする |
強化学習 | 行動の結果として得る報酬 | 試行錯誤し、将来の得点を高める行動を学ぶ |
「教師」は、画面の前で先生が指示を出すという意味ではありません。教師あり学習では、学習時に答えとなる情報を与えるということです。
強化学習は、一つ一つの場面の正解を毎回教える代わりに、報酬を手掛かりに行動の仕方を学びます。すぐの得点だけでなく、その後も含めた成果を考える場合があります。
この3つは代表的な整理で、学び方のすべてではありません。たとえば自己教師あり学習では、データの一部から、学習の手掛かりとなる答えを作ります。文章の続きを予測する学習なら、元の文章の続きそのものを答えにできます。
人が一件ずつラベルを付けていない場合もあるため、「人が正解を付けていない=必ず教師なし学習」とだけ判定しないようにしましょう。複数の方法を組み合わせる場合もあります。
分類・回帰・クラスタリングの違い
分類はカテゴリを予測し、回帰は数量などの値を予測します。クラスタリングは、データの似方を基にグループを探す方法です。
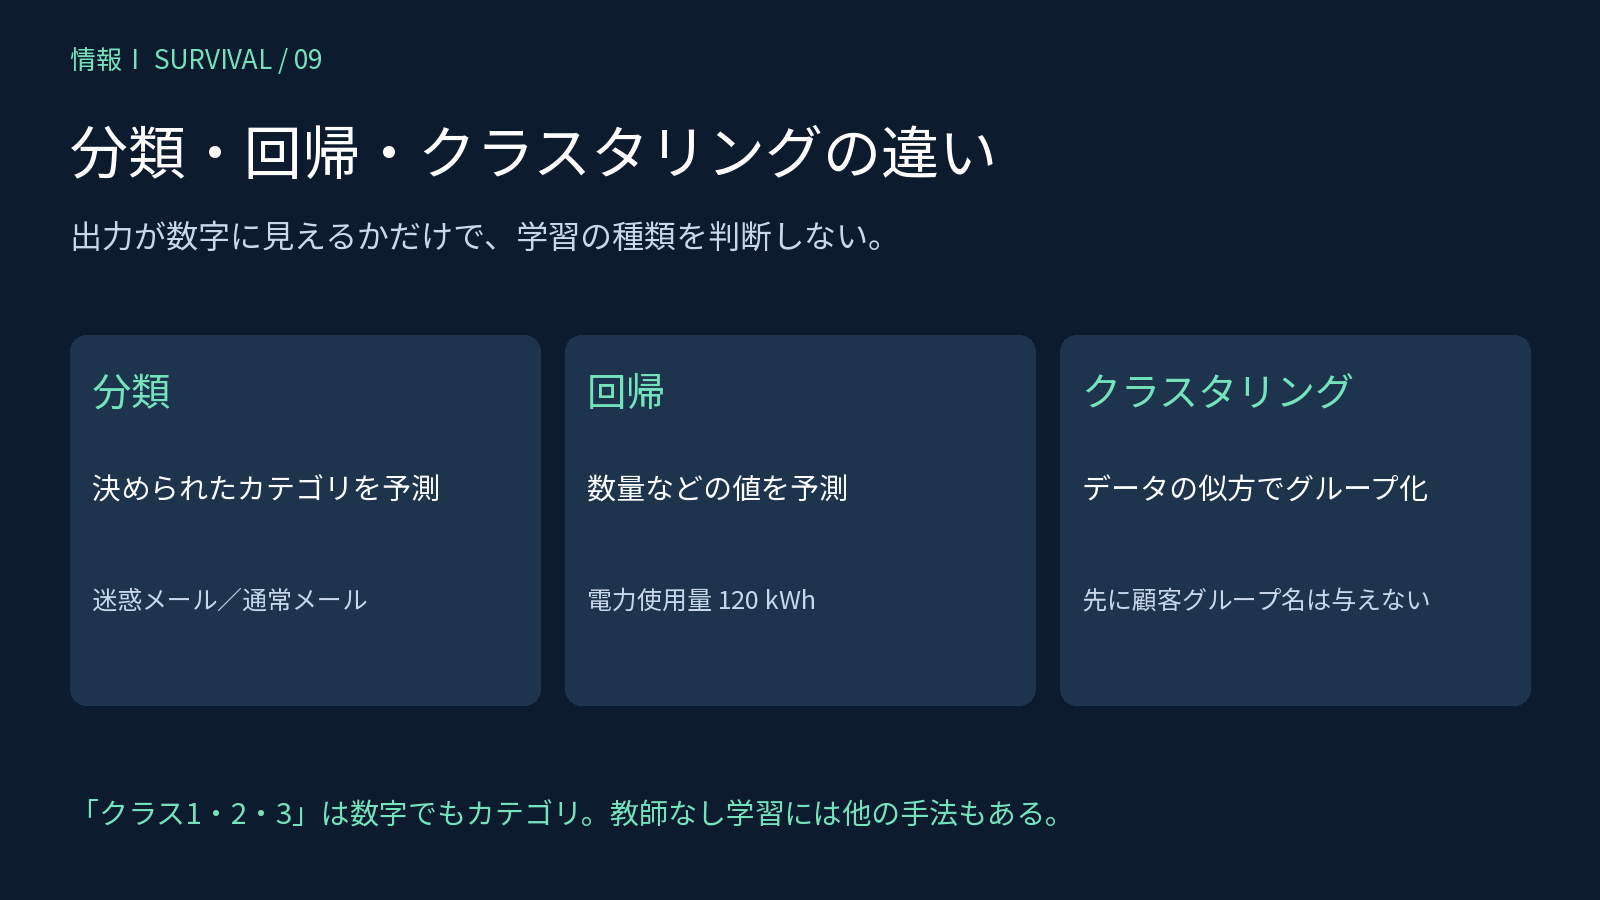
数字が出力されても、カテゴリ番号なら分類に当たる。
教師あり学習の代表的な課題が、分類と回帰です。クラスタリングと合わせて比べてみましょう。
方法 | 答えとして求めるもの | 例 |
|---|---|---|
分類 | あらかじめ決めたカテゴリ | 「迷惑メール/通常メール」を予測する |
回帰 | 数量などの値 | 明日の電力使用量を予測する |
クラスタリング | データの似方から見つけるまとまり | 正解のグループ名を与えず、購買傾向の似た顧客をまとめる |
分類は「決めた種類のどれか」、クラスタリングは「似たもののまとまりを探す」という違いです。
答えが数字で表示されるだけで回帰とは限りません。「クラス1・クラス2・クラス3」という数字がカテゴリ名なら、分類です。
クラスタリングでは、先に「この人はグループA」という正解を与えず、特徴の似たデータのまとまりを探します。ただし、何を似ているとみなすか、いくつに分けるかなどの設定によって結果は変わります。
また、教師なし学習がすべてクラスタリングというわけではありません。「似たものをまとめる」は代表例として押さえましょう。
生成AIとLLM:次のトークンを予測する
生成AIは、文章、画像、音声などを生成するAIです。文章を扱う代表的な技術に、大規模言語モデル(LLM)があります。生成AIは働きの呼び方、LLMはそれを支えるモデルの一種で、画像生成AIまで全部LLMと呼ぶわけではありません。生成した内容が、必ず独創的なものになるとも限りません。
多くの文章生成LLMでは、入力と、それまでに生成した内容を手掛かりに、続きのトークンを予測して文章を作ります。
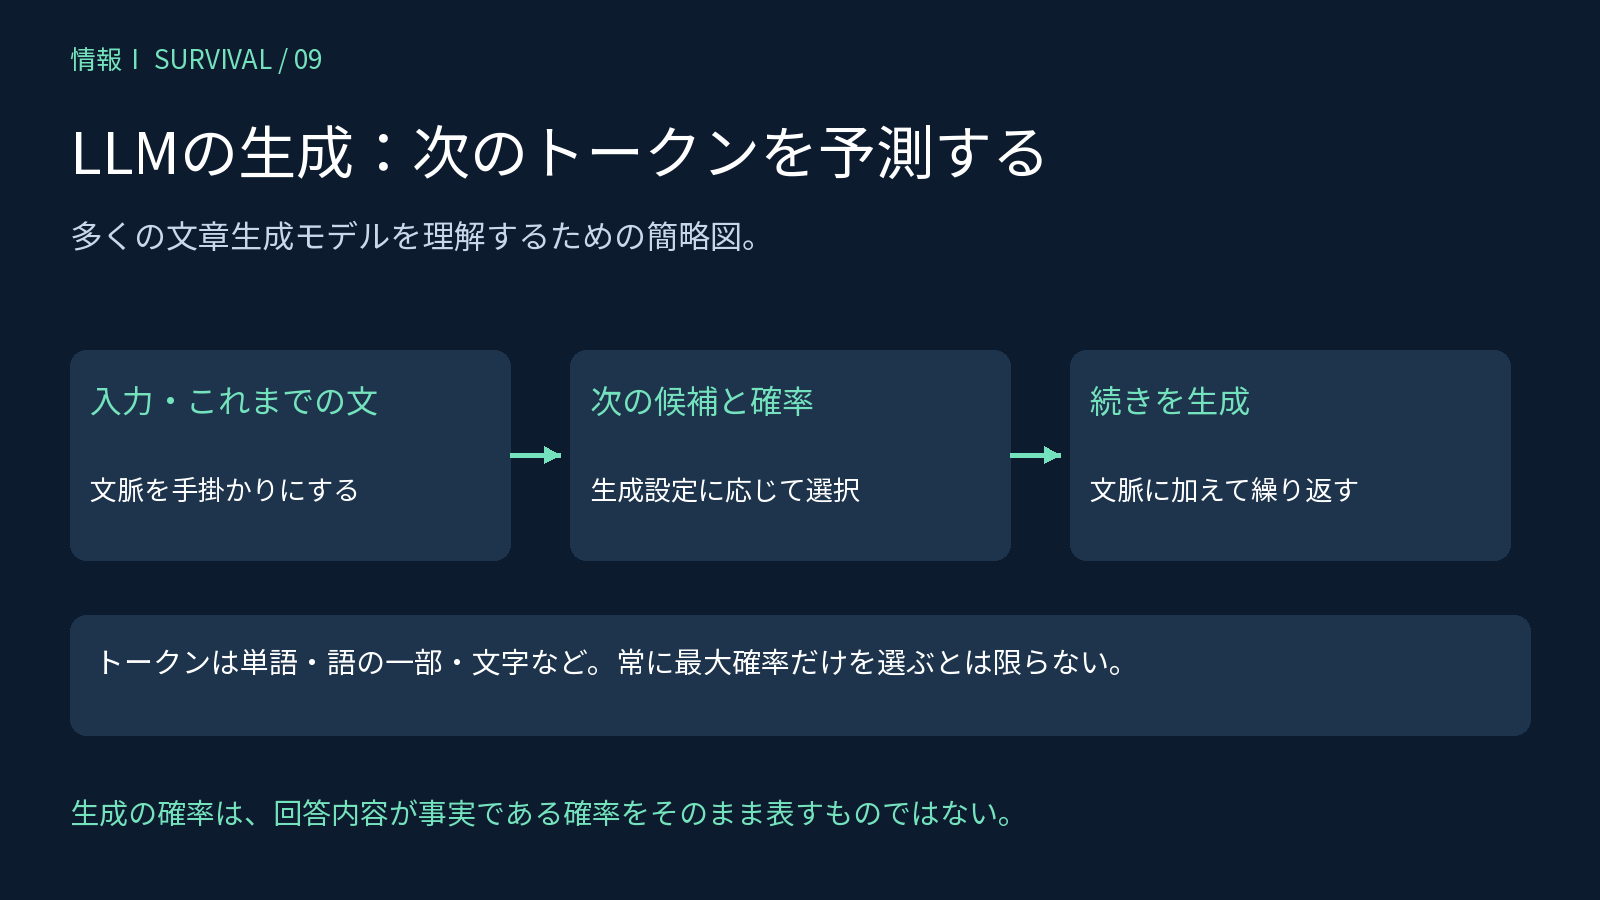
トークンの予測確率は、内容の正しさの確率ではない。
トークンは、単語そのものの場合もあれば、語の一部や文字などの場合もあります。「必ず日本語の単語を一語ずつ選んでいる」とは限りません。
モデルは次に続く候補の確率を計算し、生成時の設定に応じて選びます。最も確率が高い候補を選ぶ方法もあれば、複数の候補から確率に従って選ぶ方法もあります。常に最大確率の語だけを選ぶ、という説明は不正確です。
また、この確率は、その回答が事実である確率をそのまま表すものではありません。文章として自然でも、章の名前や数字が間違っていることはあります。
ここで説明しているのは、学習済みのモデルが文章を出力する仕組みです。会話を入力したことと、その内容でモデルが追加学習されることは別で、後者はサービスの仕組みや設定などによって異なります。
次トークン予測だけでAIの能力のすべてを説明できるわけではありませんが、「流暢なら正しい」と思い込まないための基本になります。
ハルシネーション:もっともらしい誤りに注意
ハルシネーションは、生成AIが、事実や参照した情報に合わない内容を、もっともらしく生成する現象です。 架空の章、受賞歴、出典などは、その例になります。
モデルの学習内容、入力の曖昧さ、参照情報の不足、生成の仕方などが影響します。「機械が壊れたときだけ起きる」わけではありませんが、「必ず間違う」「原因は一つ」とも言えません。
ユウキ「じゃあ、知らないって言ってくれればいいのに。」
Sandy「分からんと答えることもあるで。でも、分からん場面を毎回正確に見分けられるとは限らんねん。」
AIは「分からない」「資料が足りない」と回答することもあります。「絶対に知らないと言えない」という性質ではありません。
また、回答が誤っていることと、人のような意図で嘘をついたことは区別します。意図を決めつけるより、どの記述がどの根拠と合わないかを確かめましょう。
検索と生成、RAGはどう違う?
検索は既存の文書などを探す処理、生成は新しい回答などを作る処理です。実際のサービスでは、両方を組み合わせることがあります。
RAG(検索拡張生成)は、外部の文書などを取り出し、その内容も参照して回答を生成する仕組みです。
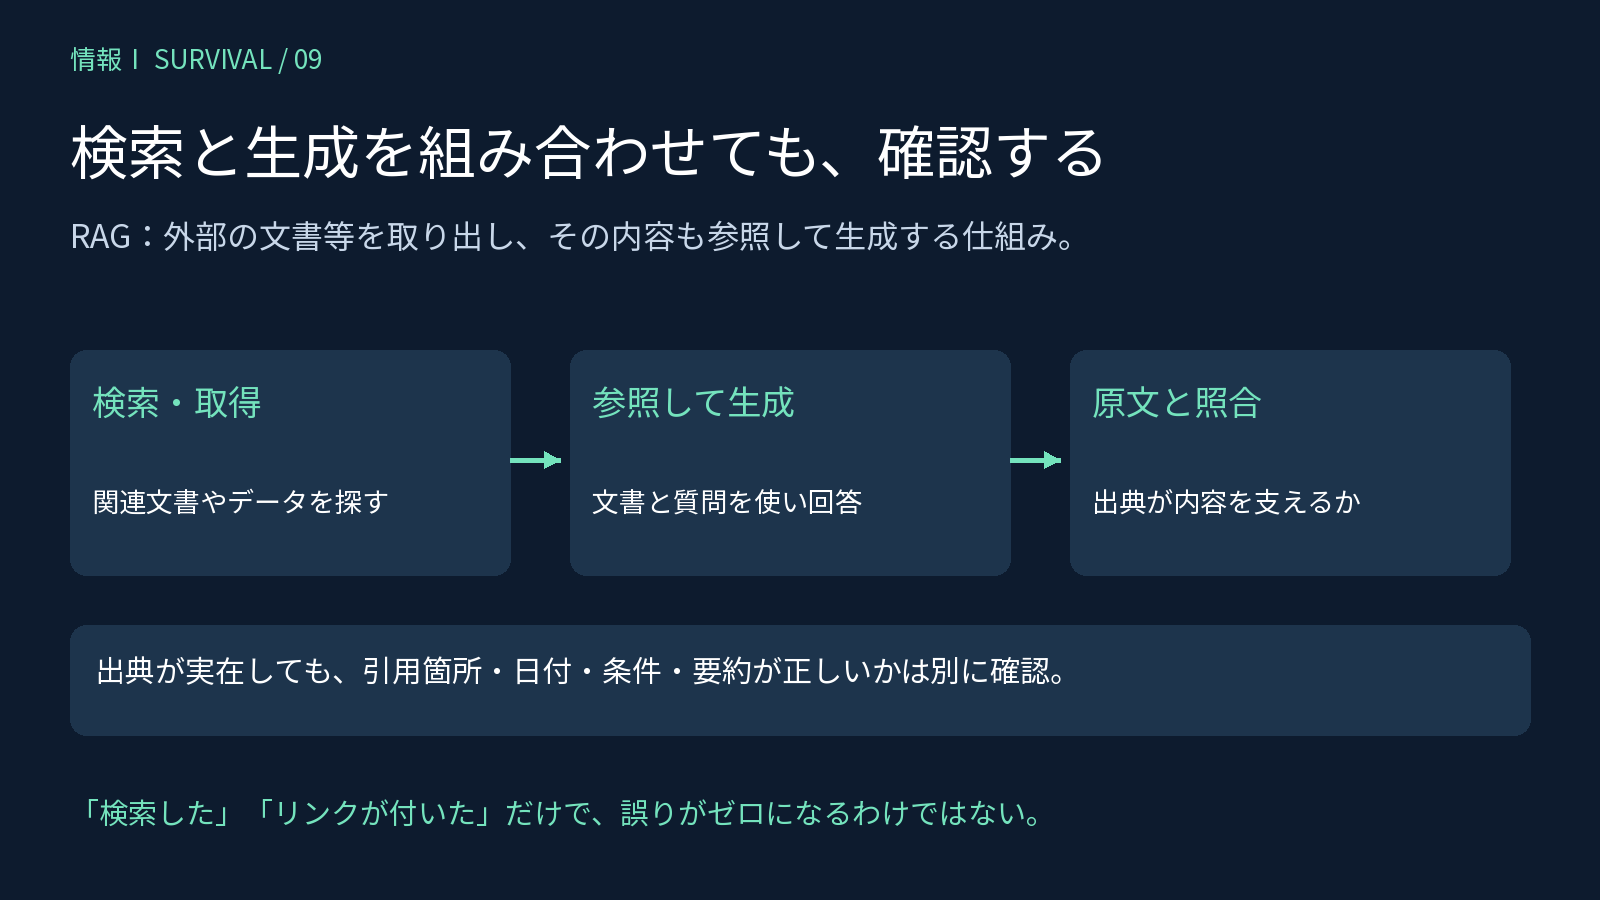
RAGを使っても、出典の存在と内容の一致を確認する。
取り出す情報は公開ウェブページだけでなく、社内文書やデータベースなどの場合もあります。検索を使わずに生成する場合とは、利用できる根拠の条件が違います。
ただし、適切な文書が見つからない、古い資料を使う、原文を読み違える、引用が回答を支えていない、といった問題は残り得ます。
出典が付いていたら、次の順で確かめましょう。
- リンク先や資料が実在するかを開いて確認する。
- 該当の文章・表・数字が、回答を本当に裏付けているか読む。
- 日付、対象、前提条件が今回の質問に合うかを見る。
- 必要に応じ、一次情報や独立した別の資料と照合する。
ユウキの感想文なら、次のように確かめます。
AIの記述 | 確かめる先 |
|---|---|
「第4章では主人公が……」 | 本そのものの目次と該当箇所 |
「この作家は○○賞を受賞した」 | 賞の主催者が公表する受賞者一覧など |
「この場面を読んで私は感動した」 | 本を読んだ自分の感想と、その根拠となる場面 |
事実の確認と、自分の感想を考えることは別の作業です。 AIに「本当に?」と聞き直すだけでは、独立した裏付けにはなりません。出典の有無と、回答内容が出典に合っているかも別です。
バイアス:学習データだけを見ればいい?
その夜、ハルカからメッセージが来ました。
ハルカ「『情報の先生っぽい人』を10枚作ったら、似た男の人ばっかり。しかも全員、眼鏡に白衣。」
これも架空の例です。10枚の結果だけで、モデル全体の偏りや原因を断定はできません。ただ、職業と性別・服装などの固定的な結び付きを考える入口になります。
AIの有害な偏りは、データの偏りだけでなく、設計・学習目標・評価・使い方など、複数の段階から生じ得ます。
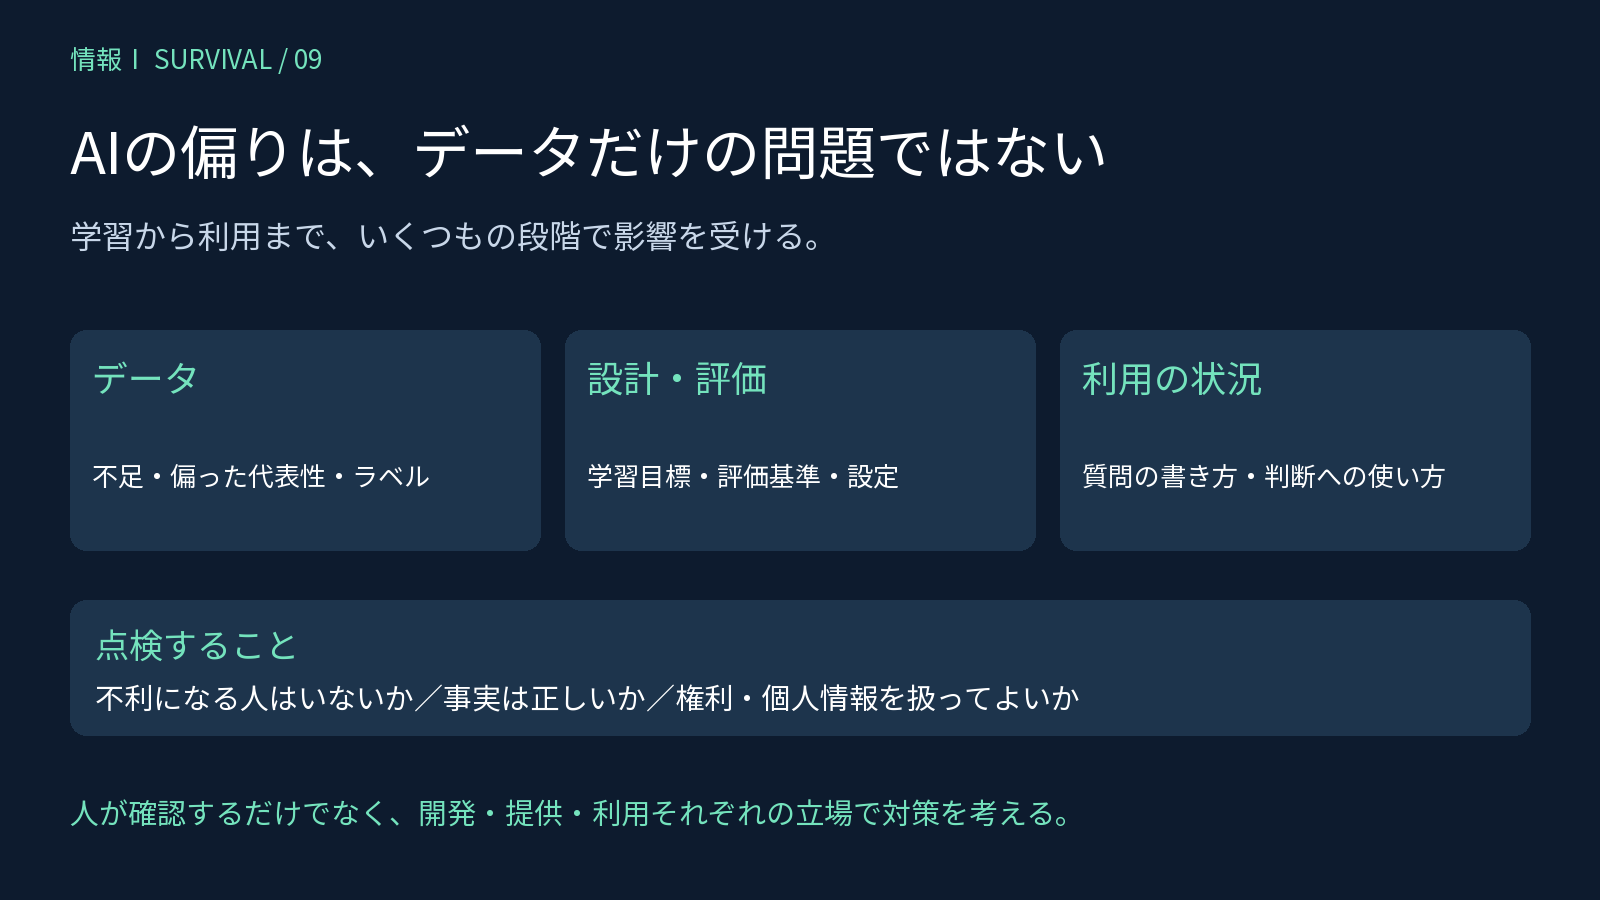
偏りの点検は、学習データだけで終わらせない。
ある集団のデータが少ない、ラベルの付け方に偏りがある、特定の評価基準しか使わない、といった条件が影響します。入力の書き方や、結果をどんな判断に利用するかも重要です。
対策も、データを増やすだけではありません。集団ごとの結果を評価し、不利を受ける人の意見を取り入れ、運用後も点検する必要があります。「人が最後に見たから、偏りは全部なくなる」とも言えません。
著作権・個人情報・説明責任も確認する
AIが生成したというだけで、利用条件や他人の権利の確認が不要になるわけではありません。
著作権では、開発・学習の段階と、生成したものを公開・利用する段階を分けます。学習には著作権法30条の4などが関係しますが、何でも無条件に利用できるという規定ではありません。
生成物の利用でも、既存の作品の創作的な表現との類似性や依拠性、許諾、法律上の例外などが問題になります。「AI製なら自由」「少し似たら全て違法」という両極端を避けましょう。
個人情報については、入力内容の保存・学習への利用などがサービスや契約、設定によって異なります。他人の名簿や相談内容を、許可や必要なルールの確認なしに入力しないことが大切です。
説明責任も、AIが理由らしい文章を出したら完了するわけではありません。その説明が実際の判断過程を示すとは限らないため、何を根拠に使ったか、どこを検証したかを説明できるようにします。
利用者には確認すべきことがありますが、開発者・提供者・導入組織にも役割があります。「責任はすべて使った一人だけ」と単純化せず、それぞれの立場で考えます。
練習:教師あり学習を使っているのはどれ?
次は本記事のオリジナル学習例です。実際の共通テスト問題ではありません。
- A:正解のグループ名を与えず、顧客を購買傾向の似方でまとめる。
- B:各日の気温と、その日の実測電力使用量の組を学習し、別の日の使用量を予測する。
- C:ゲーム内で行動を試し、結果の報酬を手掛かりに行動方針を学ぶ。
答えはBで、教師あり学習の回帰です。 学習時に、予測したい値である実測使用量が付いています。Aは教師なし学習のクラスタリング、Cは強化学習の例です。
「予測するから教師なし」「数字が出るから全部回帰」と反射せず、何を答えとして学び、何を出力するかを見ましょう。
まとめ:AIを使うときは、仕組みと確認をセットに
- AI、機械学習、ディープラーニングは入れ子の関係。
- 教師あり・教師なし・強化学習は、学ぶ手掛かりに注目する。
- LLMの次トークン予測は、内容の正しさを保証しない。
- 検索や出典が付いていても、原文との一致を確かめる。
- 偏り、著作権、個人情報も、利用する前に点検する。
翌週、ユウキは本を自分で読み、AIには考えを深める問いの候補を出してもらいました。学校や課題の利用ルールに従い、自分の感想と根拠を自分で確かめる形へ変えたのです。
説明の言い換え、問いの候補、下書きの見直しなど、学習を助ける使い方もあります。自分でWebやアプリを作ることにも挑戦したい人は、プログラミングスクールSandboxの案内をご覧ください。