送った名簿が、読めない漢字の列になって返ってきた。
友達に送った絵文字は、なぜか□になった。
どちらも「文字化け」で片付けてよいのでしょうか。
先に結論:文字の番号・バイト列・表示を分けよう
- Unicode:文字に共通の番号を付けるなど、世界の文字を扱うための規格。
- UTF-8:その番号を、保存・送信用のバイト列で表す方式の一つ。
- 文字化けと□:バイト列の読み方を間違えた場合と、字形を表示できない場合では、対処が違う。
たとえば「あ」は、UnicodeでU+3042という番号が付き、UTF-8ではE3 81 82という3バイトで表されます。読み取った番号に対応する字形を、フォントなどを使って画面に描きます。
「バイト列を正しく読むこと」と「文字の形を表示すること」は、別の段階です。 この記事では、ユウキたちの事件から、その仕組みと確かめ方を学びます。
名簿と絵文字が、同じ夜に「化けた」
夜10時。ユウキが後輩に送った部活の名簿ファイルは、相手のパソコンでは知らない漢字の列になっていました。その直後、留学中のハルカからも連絡が。
ハルカ「送ってくれた絵文字、四角しか見えないよ」
使っているのは、物語に登場する架空のメッセージアプリ「LIME」です。
ユウキ「今日は文字に嫌われてる……?」
Sandy「文字の機嫌の問題ちゃう。読み方と、表示の仕方を分けるんや」
文字もコンピュータの中では、0と1の列として扱われます。その列の単位から見ていきましょう。
ビットとバイトの違い:8ビットで1バイト
ビットは、0か1の二つの状態を表す情報の単位です。8ビットをまとめると1バイトになります。
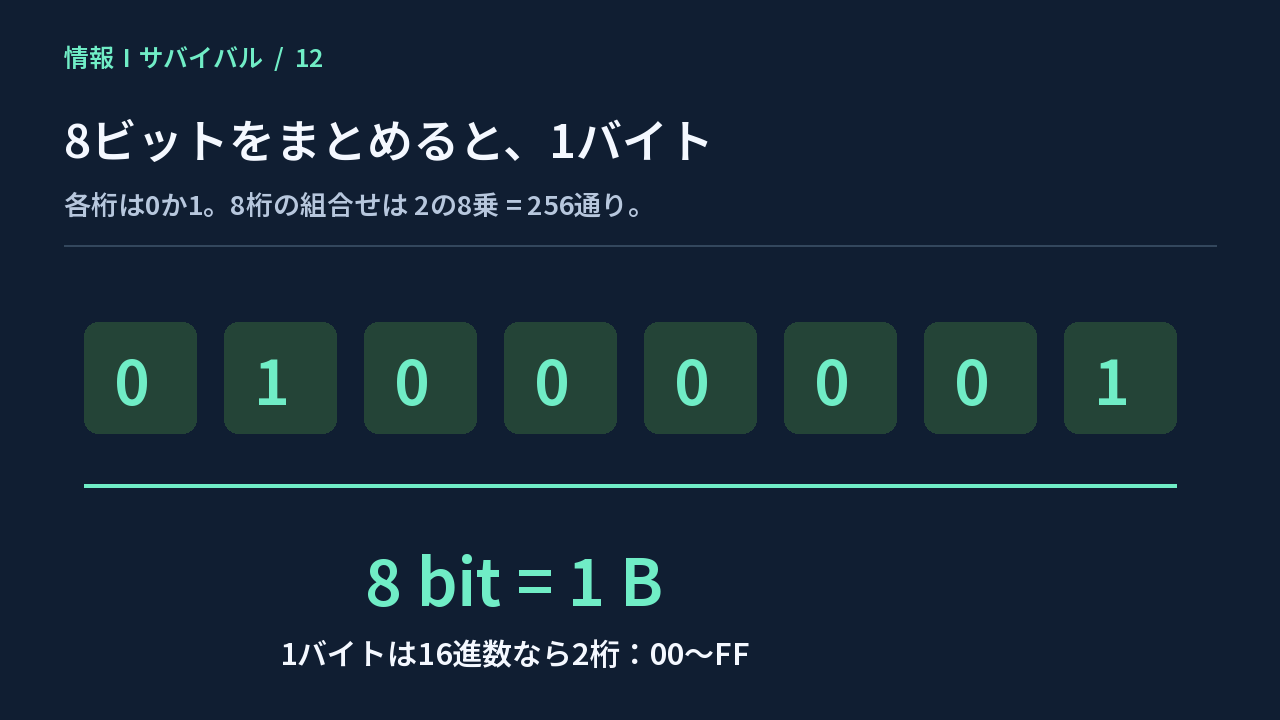
8ビット=1バイト。1バイトの組合せは256通りです。
1ビットなら2通り、2ビットなら4通り。桁を一つ増やすたびに組合せは2倍になり、8ビットでは2の8乗=256通りになります。符号なし整数として読むなら0〜255です。
2バイトは16ビットなので65,536通り。ただし、これはビット列の組合せの数です。「実際に65,536文字が使える」「1文字は必ず2バイト」という意味ではありません。
表記にも注意が必要です。Bはバイト、bはビットを表すのによく使われます。
表記 | 意味 | 注目すること |
|---|---|---|
MB | メガバイト | データの量 |
Mbps | メガビット毎秒 | 1秒あたりに伝えるデータの量 |
MB/s | メガバイト毎秒 | 同じく速度だが、単位はバイト |
8ビット=1バイトなので、80Mbps÷8=10MB/sです。これは単位の換算で、実際のファイル転送速度の保証ではありません。通信の付加情報や待ち時間なども影響します。
kBとKiB:1000倍と1024倍を区別する
容量の単位では、1000倍の系列と1024倍の系列を分けて考えます。
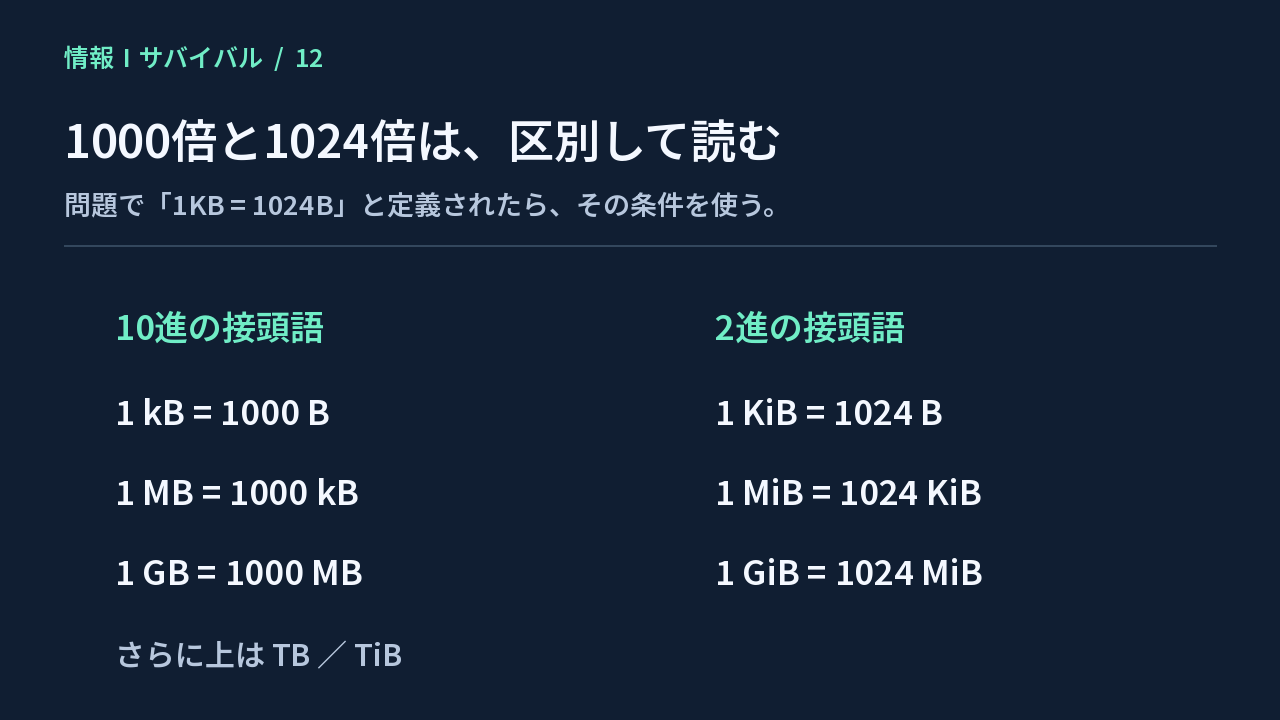
1000倍と1024倍を区別し、問題文に定義があればそれに従います。
10進の接頭語 | 値 | 2進の接頭語 | 値 |
|---|---|---|---|
kB(キロバイト) | 1000B | KiB(キビバイト) | 1024B |
MB(メガバイト) | 1000kB | MiB(メビバイト) | 1024KiB |
GB(ギガバイト) | 1000MB | GiB(ギビバイト) | 1024MiB |
TB(テラバイト) | 1000GB | TiB(テビバイト) | 1024GiB |
従来の資料や製品では、KBなどの表記が1024倍の意味で使われることもあります。試験問題で「1KB=1024Bとする」と指定されたら、その条件に従いましょう。
Sandy「単位を見たら、まず約束を確認や。1000と1024を、気分で入れ替えたらあかんで」
文字コードとは?文字と番号を対応させる約束
文字を保存するには、文字と番号を対応させ、その番号をバイト列で表す約束が必要です。「文字コード」という言葉は、こうした文字の対応関係や符号化方式を指して使われます。
代表例のASCIIは、7ビットで128通りを表します。英字・数字・記号のほか、改行などに関係する制御文字を含み、日本語のかなや漢字は含みません。大文字Aの番号は10進数で65、16進数で41です。
日本語を扱うためには、Shift_JISやEUC-JPなども使われてきました。たとえば「あ」はShift_JISなら82 A0、EUC-JPならA4 A2です。表や方式が違えば、同じ文字のバイト列も違います。
ユウキ「日本語って、1文字2バイトって習った気がする」
Sandy「どの方式の、どの文字かが大事やで」
Shift_JISの多くのかな・漢字は2バイトですが、半角カタカナなどは1バイトです。「日本語だから必ず2バイト以上」と一律には決められません。
UnicodeとUTF-8の違い:文字の番号と表し方
Unicodeは、世界のさまざまな文字を共通して扱うための規格です。文字に符号位置(コードポイント)を割り当てるほか、文字の性質なども定めています。
「あ」の符号位置はU+3042。U+の後ろは16進数です。Unicodeを学び始めるときは、まず「文字に共通の番号が付いている」と考えると理解しやすくなります。
その符号位置を具体的なバイト列にする方式の一つがUTF-8です。
段階 | 「あ」の例 | 何を決める? |
|---|---|---|
文字の番号 | U+3042 | どの文字かを識別する |
バイト列での表現 | UTF-8ではE3 81 82 | どんなデータとして保存・送信するか |
画面への表示 | フォントなどで「あ」の字形を描く | どんな形で見せるか |
UnicodeとUTF-8は、どちらか一方を選ぶ対立した規格ではありません。 Unicodeの文字をUTF-8で表す、という関係です。
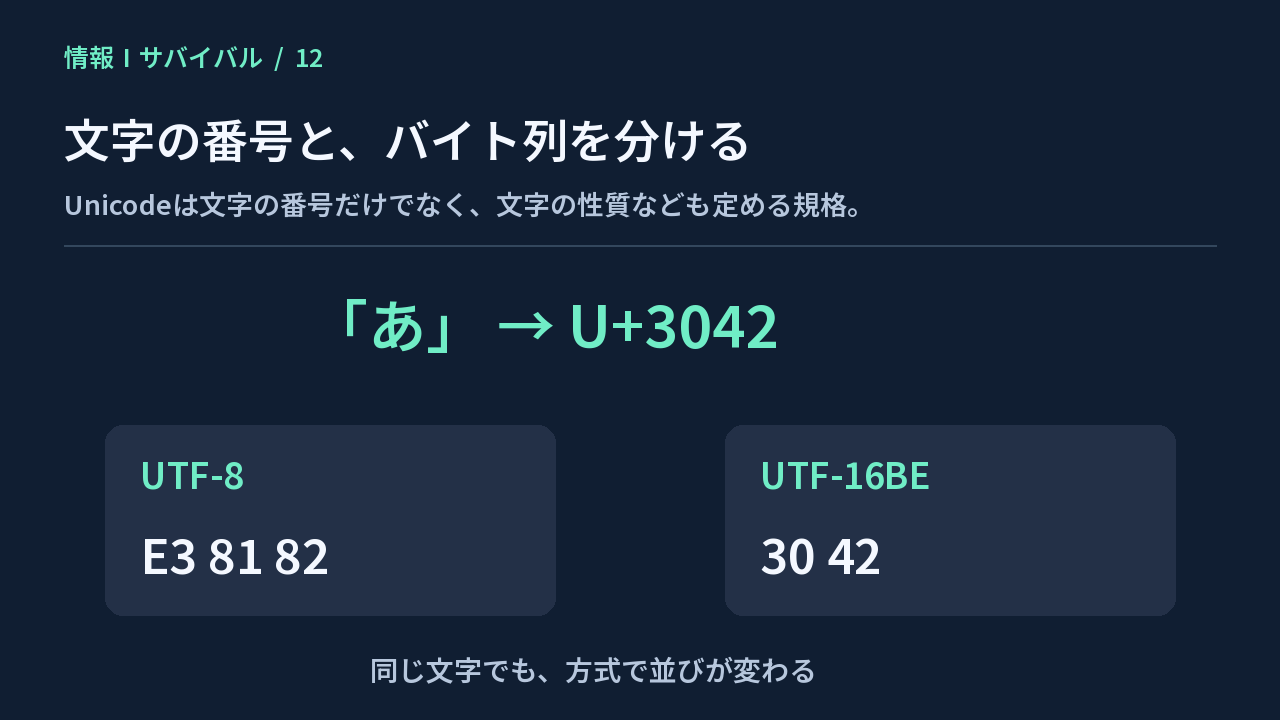
同じ符号位置でも、符号化方式とバイト順で並びが変わります。
文字 | Unicodeの符号位置 | UTF-8のバイト列 | UTF-16BEのバイト列 |
|---|---|---|---|
A | U+0041 | 41 | 00 41 |
あ | U+3042 | E3 81 82 | 30 42 |
表のバイト列は16進表記です。UTF-16BEのBEは、上位のバイトを先に置く順序を示します。UTF-16LEなら「あ」は42 30になります。表ではBOMという先頭の目印は含めていません。
Sandy「同じ番号でも、荷造りの仕方が変わるんや」
ユウキ「UnicodeとUTF-8は、対立する別々の文字表じゃないんだね」
UTF-8もUTF-16もUnicodeの文字を表す方式です。UTF-16では、「あ」は2バイトですが、😀は4バイトです。「Unicodeは番号だけの規格」「UTF-16は必ず1文字2バイト」という丸暗記は避けましょう。
UTF-8の文字数とバイト数は一致しない
UTF-8では、一つの符号位置を1〜4バイトで表します。ASCIIの範囲は1バイト、「あ」などの一般的なひらがなは3バイト、絵文字の😀(U+1F600)は4バイトです。
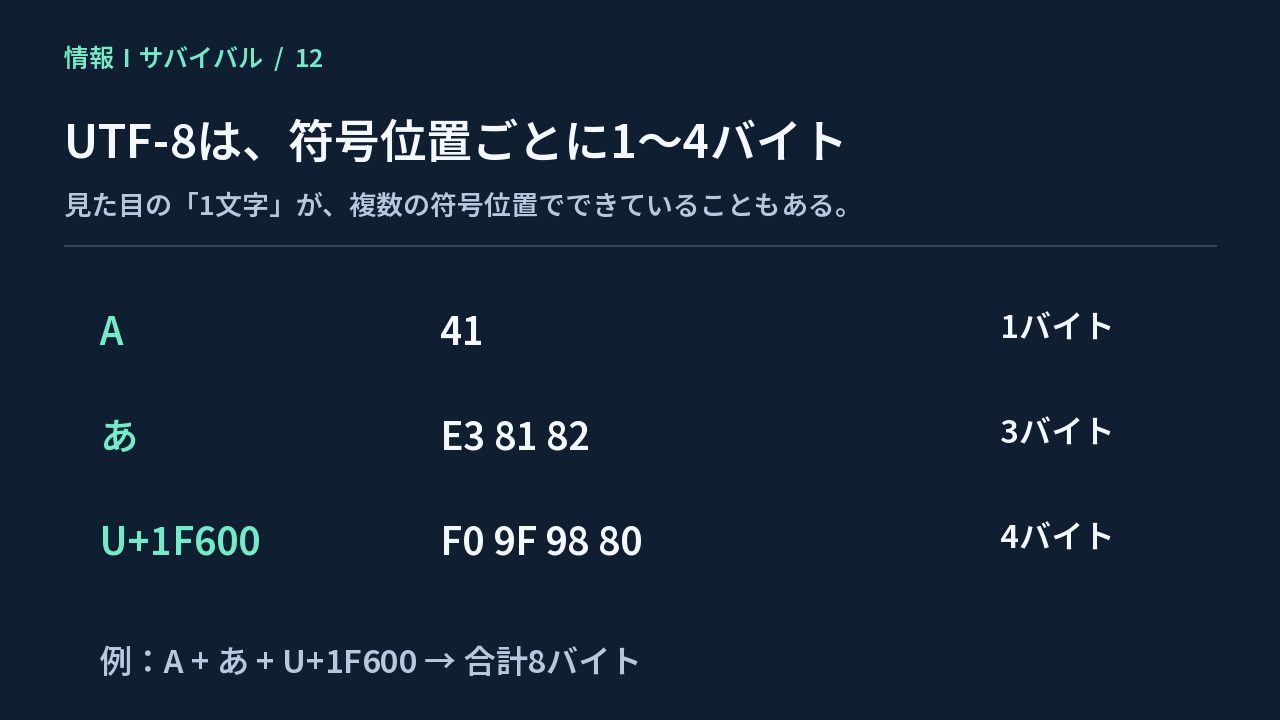
UTF-8では符号位置ごとに1〜4バイト。見た目の1文字と同じとは限りません。
ただし、すべての絵文字が見た目の1文字で4バイトになるわけではありません。 家族や国旗など、複数の符号位置を組み合わせた表示もあります。漢字にもUTF-8で4バイトになるものがあります。
文字数からデータ量を求めるときは、方式を確認→文字ごとのバイト数を確認→合計の順で考えます。
たとえばUTF-8の「Aあ😀」は、Aが1バイト、あが3バイト、😀が4バイトなので、合計8バイトです。ファイル全体のサイズを求めるなら、改行やBOM、ファイル形式による付加情報なども別に考えます。
文字化けと□の違い:読み取りと表示を分ける
UTF-8で保存した「佐藤」は、16進表記でE4 BD 90 E8 97 A4という6バイトです。このバイト列をShift_JISとして読むと、「菴占陸」という別の文字列になります。
元のバイト列が壊れていなくても、解釈の方式を間違えるだけで、文字化けは起こります。
一方、文字の番号を正しく読み取れていても、対応する字形(グリフ)や表示機能がなければ、□などの代替表示になることがあります。
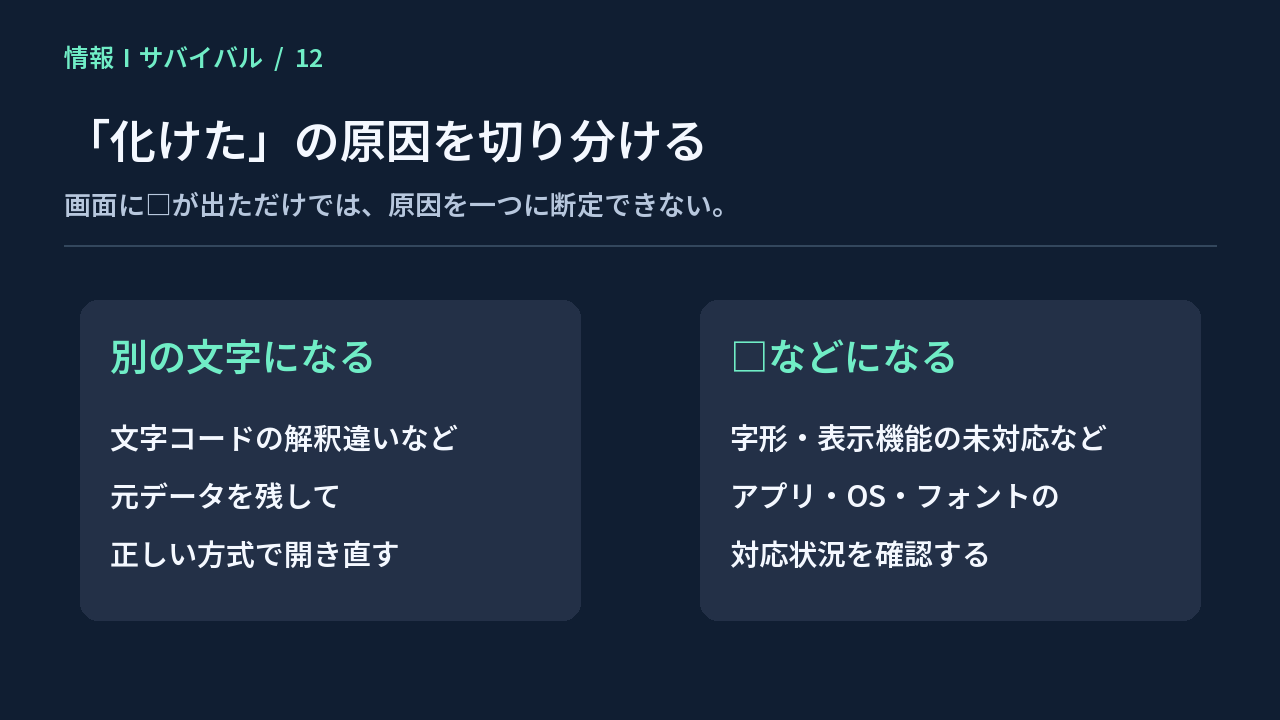
元データを残し、読み取り方式と表示環境を分けて確認します。
状況 | 考えられる原因 | 確認すること |
|---|---|---|
別の文字列になる | 文字コードの解釈違いなど | 保存側の方式と、開く側の設定 |
□や代替記号になる | 字形・描画機能の未対応など | OS・アプリ・フォントの対応 |
�などになる | 不正なバイト列の置換など | 元データと、変換・読み取り処理 |
見た目だけで原因が一意に決まるわけではありません。実際に□という文字を送っていたり、途中でデータが変わっていたりする場合もあります。
直すときは、元ファイルを残しておく
文字化けした画面のまま上書き保存すると、誤った文字列が新しいデータとして保存され、元に戻せなくなることがあります。
次の順で調べましょう。
- 元データを残す。 ファイルを複製し、調べる間は元を上書きしない。
- 保存時の方式を確かめる。 送信者や作成アプリの設定を確認する。
- 同じ方式で開き直す。 UTF-8で保存したならUTF-8、Shift_JISならそれに対応する設定で読む。
- 表示も確認する。 絵文字などが表示できない場合は、OS・アプリ・フォントの対応や、別の表示環境を調べる。
「何でもUTF-8にすれば直る」「□なら必ずフォントだけが原因」とは決めつけず、どの段階で問題が起きたかを確かめます。
ユウキ「辞書を間違えたのか、その字を書く道具がなかったのか」
Sandy「ええ分け方や。ただ、四角を見ただけで即断せんことやな」
文字コードと暗号化の違い:読めないだけでは秘密にならない
UTF-8のバイト列を見て「暗号みたい」と感じても、符号化は秘密を守る仕組みではありません。方式に従えば、秘密の鍵なしで文字に戻せます。
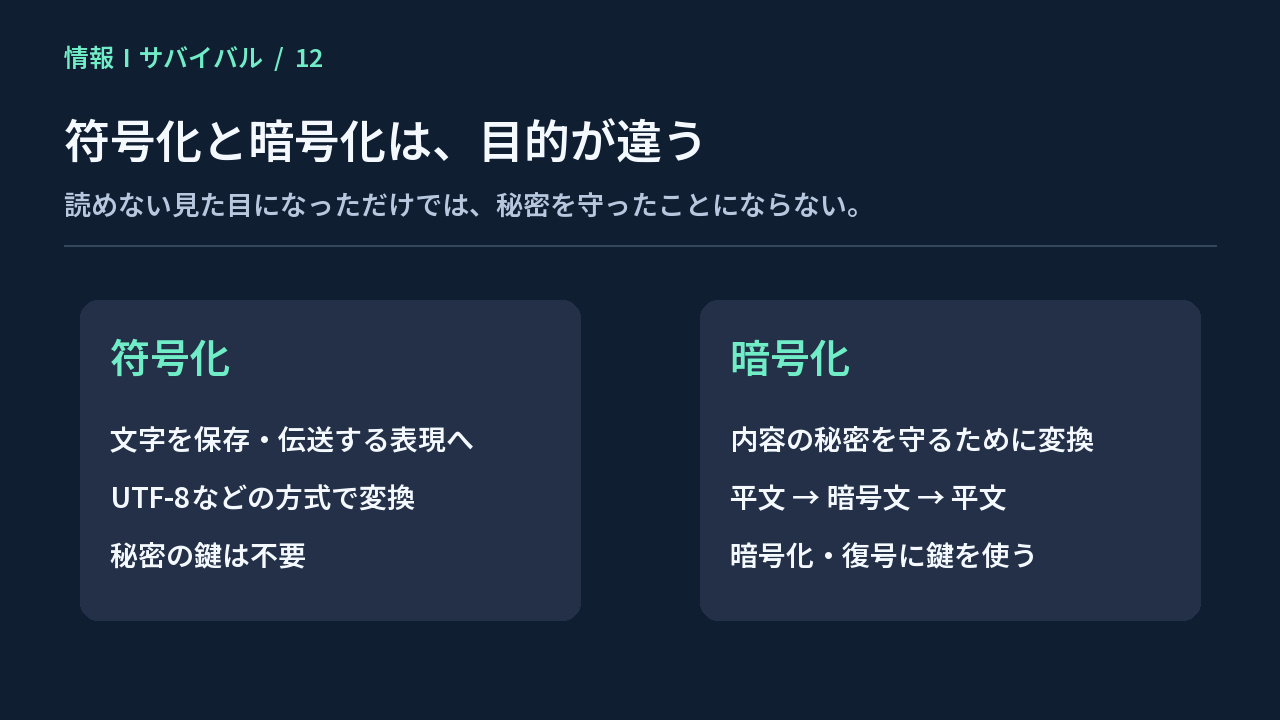
符号化しただけでは、情報の秘密を守れません。
暗号化は、内容の秘密を守るために、平文を暗号文へ変換する処理です。暗号文を元に戻すことを復号といいます。 その処理で使う重要な値が鍵です。
方式 | 暗号化・復号に使う鍵 | 押さえる点 |
|---|---|---|
共通鍵暗号方式 | 同じ鍵 | 相手と安全に鍵を共有する必要がある |
公開鍵暗号方式による暗号化 | 対になった公開鍵と秘密鍵 | 受信者の公開鍵で暗号化し、受信者の秘密鍵で復号する |
公開鍵は、誰でも閉められる南京錠にたとえられます。受信者の公開鍵で閉めた箱は、対応する秘密鍵を持つ受信者が開ける、というイメージです。
ただし、公開鍵が本当に相手のものかを確認することも必要です。また、公開鍵と秘密鍵を使う処理には電子署名などもあり、この比喩は暗号化の説明に限ります。
ユウキ「文字化けした名簿、暗号化できてたわけじゃないんだ」
Sandy「読みにくさと安全性は別や。名簿を守るなら、共有先やアクセス権も確認せなな」
練習:文字数からバイト数を計算してみよう
以下はこの記事のオリジナル学習例です。実際の共通テスト問題ではありません。BOM、改行、ファイル形式や通信の付加情報は含めません。
問1:UTF-8で「ありがとう」を表すと何バイト?
答えは15バイトです。この5文字は、それぞれ3バイト。3×5=15になります。Shift_JISなら各2バイトで計10バイトになるため、最初に方式を確認することが重要です。
問2:UTF-8で「Aあ😀」を表すと何バイト?
答えは8バイト。Aが1、あが3、この絵文字が4なので、1+3+4=8です。「3文字だから3バイト」にはなりません。
問3:UTF-8で保存したファイルを、違う方式で開いたら文字化けしました。元データは残っています。最初に何を確認する?
保存したときの文字コードと、読み取り側の設定を確認します。元ファイルを残してUTF-8で開き直すのが、この条件に合った対応です。表示の問題かどうかを確かめず、フォントだけを変えても解決するとは限りません。
まとめ:番号・バイト列・字形を分けて考える
翌日の放課後。ユウキと後輩は元の名簿を正しい文字コードで開き、名前を読めるようになりました。ハルカの絵文字も、表示環境の更新で見えるようになりました。物語の二つの事件は、原因に合った手当てで解決したのです。
- 8ビット=1バイト。文字数とバイト数は同じとは限らない。
- Unicodeの符号位置と、UTF-8などによるバイト列の表現を分ける。
- 文字化けは解釈違い、□は表示未対応などを疑い、元データを残して調べる。
- 符号化と暗号化は目的が違う。秘密を守るには別の仕組みが必要。
2進数・16進数の計算があやふやな場合は、桁の重みと4ビットの対応を復習すると、今回のバイト列も読みやすくなります。文字やデータの仕組みをアプリ制作でも確かめたい人は、プログラミングスクールSandboxもご覧ください。